Grundidee
Bei der Indexsuche benötigt man ein zweites Array, das als Index-Array bezeichnet wird. In diesem Index-Array werden jetzt bestimmte Indizes des eigentlichen Arrays gespeichert. Betrachten wir dazu das folgende Bild:
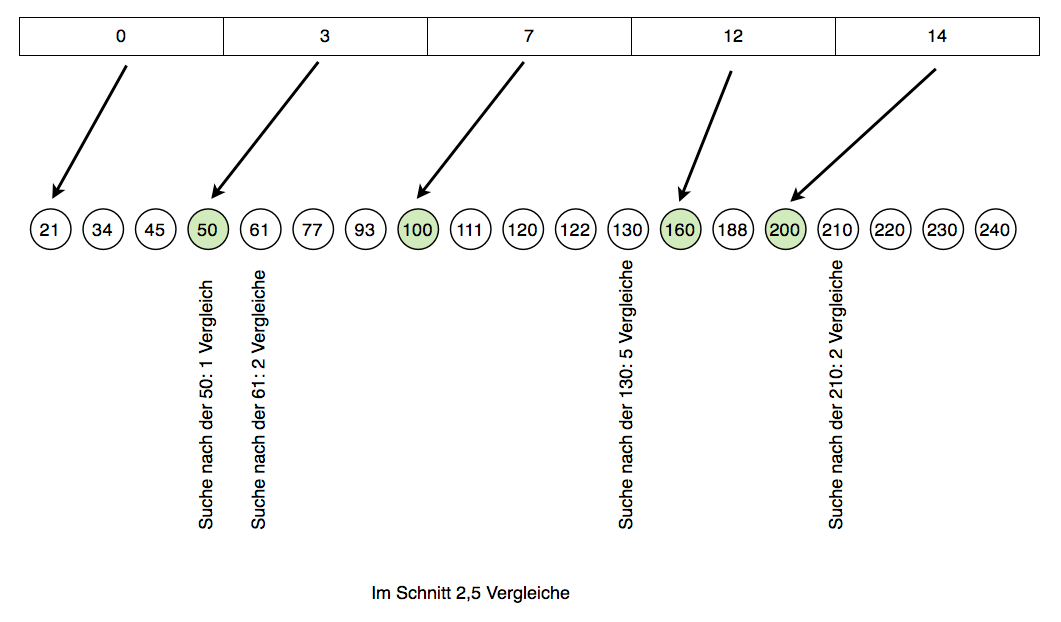
Schema zur Interpolationssuche
Autor: Ulrich Helmich 2019, Lizenz: Public domain.
Das zu durchsuchende Array besteht aus 19 int-Zahlen:
21-34-45-50-61-77-93-100-111-120-122-130-160-188-200-210-220-230-240
Nun werden die Indizes herausgesucht und in dem Index-Array gespeichert, an denen zum ersten Mal eine Zahl >= 50, >= 100, >= 150 und >= 200 vorkommt.
Das sind die Positionen 3 (Index der Zahl 50), 7 (Zahl 70), 12 (Zahl 160) und 14 (Zahl 200).
Das Index-Array besteht also aus den Zahlen
0-3-7-12-14
Suchvorgang
Beispiel 1
Wir wollen jetzt die Zahl 57 suchen. Der Index der Zahl 50 müsste im Index-Array an der Position 1 stehen. Wenn die 50 nicht in dem Haupt-Array vorkommt, steht der Index der nächst größeren Zahl an Position 1 des Index-Arrays.
Wir suchen nun den Index-Array auf und sehen, dass an Position 1 die Zahl 3 steht.
Also beginnen wir mit der Suche im Haupt-Array an Index 3. Dort steht die Zahl 50. Wir suchen aber die Zahl 57. Wir führen ab jetzt einfach eine sequentielle Suche durch und sehen bereits bei der nächsten Zahl - der 61 - dass die 57 nicht im Array vorkommen kann.
Beispiel 2
Jetzt wollen wir nach der Zahl 122 suchen. Diese Zahl ist größer als 100, aber kleiner als 150. Daher schauen wir an Position 2 im Index-Array nach. Dort steht die Zahl 7. Das heißt, wir beginnen mit der sequentiellen Suche im Haupt-Array an der Position 7. Dort steht die 100. Die nächste Zahl ist die 111, gefolgt von der 120 und schließlich der 122.
Verteilung der Daten im Haupt-Array
Die Indexsuche eignet sich übrigens auch dann, wenn die Daten des Haupt-Arrays sehr unregelmäßig verteilt sind:
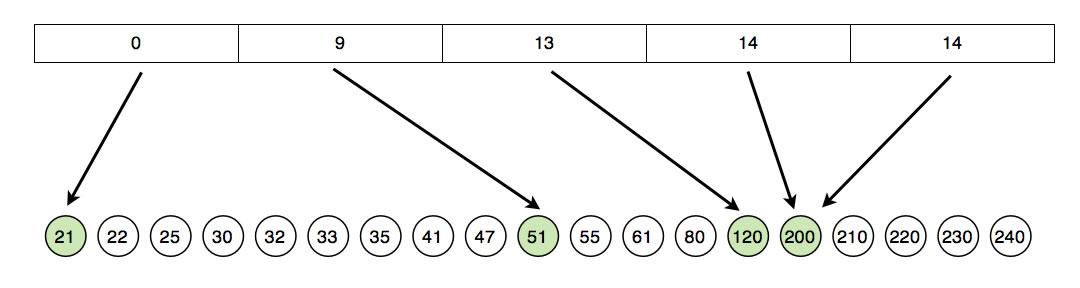
Eine ungleichmäßige Verteilung der Elemente
Autor: Ulrich Helmich 2019, Lizenz: Public domain.
Die erste Hälfte des Arrays wird von Zahlen kleiner als 50 eingenommen, in der rechten Hälfte finden sich dann Zahlen zwischen 51 und 240. Die Zahlen sind also recht ungleichmäßig verteilt. Dennoch kann hier eine Indexsuche durchaus hilfreich sein.
Optimierungen
- Die Zahl der Partitionen könnte erhöht werden. Das würde einerseits die Suche im Haupt-Array beschleunigen, andererseits aber die Suche nach dem Einstiegs-Index verlangsamen, da das Index-Array größer würde.
- Das Suchverfahren innerhalb der Partitionen könnte verbessert werden. Wir haben bei unserem Beispiel eine schlichte sequentielle Suche verwendet. Man könnte innerhalb einer Partition aber auch binär suchen, was die Suchzeit noch einmal stark beschleunigen würde.
KI-Recherche zu den Suchzeiten
Prompt:
Gegeben ist ein Array aus 10.000 zufällig gewählten Ganzzahlen zwischen 1 und 50.000. Das Array ist aufsteigend sortiert.
Berechne die durchschnittlichen Suchzeiten nach beliebigen Zahlen zwischen 1 und 50.000. Ein Teil der Suchzahlen ist in dem Array vorhanden, ein anderer Teil nicht.
Wie groß ist die durchschnittliche Suchzeit für
- Eine Sprungsuche mit Sprungweiten von 100 ?
- Eine Indexsuche, bei der im Index-Array die Indizes von Zahlen >= 1000, >= 2000, ... , >= 49.000 gespeichert sind?
Ergebnis von Mistral Vibe (stark gekürzt):
Sprungsuche: ≈ 50,5 + 50 ≈ 100–102 Vergleiche im Durchschnitt – unabhängig davon, ob die Zahl enthalten ist. Meine Simulation bestätigt: ≈ 102 Vergleiche
Indexsuche: 25 + 100 ≈ 125–127 Vergleiche im Durchschnitt (Simulation: ≈ 127).
Nachfrage (Prompt):
Wie sähen die optimalen Werte für Blockgrößen für die beiden Beispiele aus und welche Ergebisse würde man dann erzielen?
Ergebnis (gekürzt):
Die Spriungweite bei der Sprungsuche ist bereits optimal gewählt.
Bei der Indexsuche wäre eine geringere Blockgröße sinnvoll: >= 500, >= 1000, >= 1500, ... >= 49.500. Die durchschnittliche Suchzeit läge dann bei 100 Vergleichen.